Анализ отрасли · 22 июля 2026
Gemini 3.6 Flash: реакция на запуск и тест покупки агента
Пересмотрите критику запуска Gemini 3.6 Flash, проверьте устаревшие цены API и сравните модели агентов по принятым результатам, времени проверки и стоимости повторной попытки.
Июльский запуск показал, почему скорость и качество нужно проверять отдельно. Текущие цены изменились; выберите модель, используя стоимость принятых задач, затраченное время и усилия на проверку для своей рабочей нагрузки.
Июльский запуск Gemini 3.6 Flash поднял полезный вопрос для разработчиков агентов: сколько стоит более быстрое выполнение, если широкая оценка качества остается на том же уровне? Модель может стать полезным операционным обновлением, не являясь лучшим выбором для каждой задачи.
Источники проверены 27 октября 2026 г. Это обновление отделяет запись о запуске в июле от текущей документации и добавляет упражнение для сравнения. Mantis не выполнял приведенное ниже сравнение; его проверки являются предложенными критериями приемки, а не фактическими результатами.
Редакционная корректировка: предыдущая версия рассматривала цены на запуск и позиции в таблице лидеров как текущие рекомендации по покупке и слишком широко описывала мнение сообщества. Эти утверждения были уточнены. Старое общее упоминание «последней модели» теперь охватывает Gemini 4 Argon, поэтому здесь оно заменено документацией по конкретной модели.
Что изменилось с момента запуска
Google Страница модели Gemini 3.6 Flash, обновлённый 22 октября, описывает его как модель предыдущего поколения, которая всё ещё доступна для производственного использования, и указывает на Gemini 3.8 Flash как на более новую опцию Flash. Эта статья рассматривает дебаты по запуску версии 3.6; она не оценивает весь современный рынок моделей.
С Страница ценообразования Gemini Developer API перечисляет следующие стандартные платные тарифы для Flash 3.6, за миллион токенов в долларах США:
| Категория токенов | До 31 декабря 2026 года | Начиная с 1 января 2027 года |
|---|---|---|
| Ввод | $0.75 | $1.50 |
| Вывод, включая размышления | $3.75 | $7.50 |
Это опубликованные ставки, проверенные 27 октября, а не оценка счета. Batch, Flex, Priority, кэширование и grounding имеют отдельные позиции ценообразования. Проверьте свой уровень перед запуском и включите расходы на инструменты в его общую стоимость. Сравнение запуска с Luna не может определить сегодня самый дешевый вариант.
График запуска и лидерская таблица рассказывают разные истории
Google Объявление 21 июля акцентировало внимание на выбранных рабочих нагрузках агента. Сообщаемые сравнения с 3.5 Flash были:
- DeepSWE: 49% против 37%.
- MLE-Bench: 63,9% против 49,7%.
- GDPval-AA v2: 1421 против 1349.
- OSWorld-Verified: 83,0% против 78,4%.
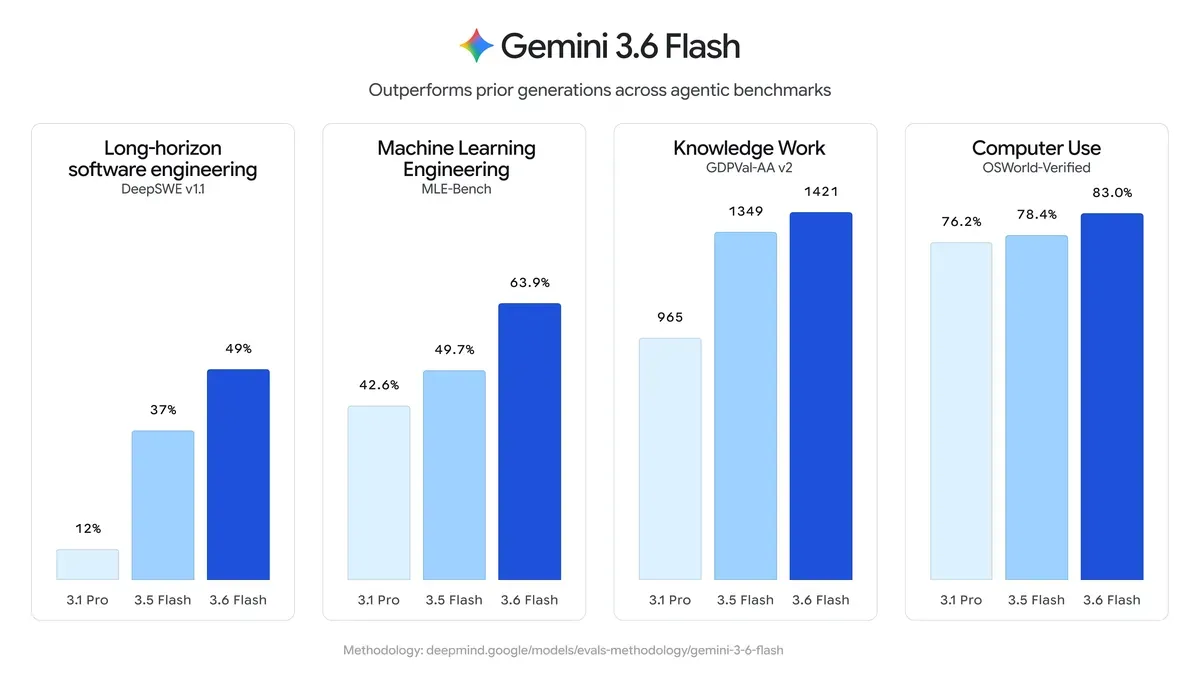
Выборочная оценка рабочей нагрузки и составной индекс отвечают на разные вопросы. Ни один из них не говорит вам, пройдет ли агент тесты вашего репозитория, сохранит ли запрошенный объем изменений или уложится в ваш бюджет. Модель, запрос, инструменты и процедура оценки — все это должно быть включено в записку для сравнения.
Как Gemini 3.6 Flash был оценен при запуске
Отчет Artificial Analysis от 21 июля является устаревшим первоисточником от самого оценщика. Для высокоразвитого мышления он сообщил:
| Измерить | Gemini 3.6 Flash | Gemini 3.5 Flash |
|---|---|---|
| Индекс интеллекта | 50 | 50 |
| Среднее время на задачу | 1,3 минуты | 2,7 минуты |
| Оценочная стоимость на одну эталонную задачу | $0.50 | $0.59 |
Оценщик также зафиксировал около 304 выходных токенов в секунду в тестировании перед запуском и поставил GPT-5.6 Luna на максимум рассуждений на 51 индексный пункт. Это исторические наблюдения. Один и тот же результат не доказывает одинаковую способность к выполнению каждой задачи, а разница в один балл не определяет, какая модель выполнит вашу задачу.
Мы убрали порядковые позиции в рейтинге из рекомендаций по покупке, так как рейтинги меняются в зависимости от набора для сравнения и версии оценки. Оценка стоимости задачи на момент запуска не должна использоваться с сегодняшними ценами.
Что на самом деле устанавливает реакция сообщества
С связанное обсуждение сообщества Gemini представил выпуск как слабую ценность. Его комментарии также включают защиту скорости и несогласие с измерениями галлюцинаций. Это показывает дебаты, а не репрезентативное исследование разработчиков.
Ранее опубликованная статья включала сравнение X и описывала его как широко распространенное. Этот пост не удалось перепроверить во время обновления, так как источник вернул ошибку доступа. Мы удалили вставку и неподдерживаемое утверждение о охвате. Перепубликованная диаграмма недостаточна в качестве доказательства текущих цен или того, как большинство пользователей себя чувствовало.
Переведите критику в тестируемый вопрос: выполняет ли кандидат ту же работу с меньшим количеством повторных попыток и меньшим временем ожидания, при этом достигая вашего уровня качества?
Почему скорость все еще имеет значение
Разработчики, создающие агентов, платят не только за правильные конечные ответы. Они платят временем реального хода, вызовами инструментов, неудачными циклами, сгенерированными токенами и задержкой, прежде чем агент сможет восстановиться после ошибки.
Быстрая генерация токенов — это только часть этого цикла. Быстрый ответ, который вызывает ещё одно редактирование, тестирование и проверку, может заставить вас дольше ждать принятого результата. Наоборот, краткий правильный ответ может сократить работу, не повышая композитный балл.
С страница API, специфичная для модели перечисляет текстовые, графические, видео-, аудио- и PDF-входы с текстовым выводом. Указывается 1 048 576 входных токенов и 65 536 выходных токенов, и использование компьютера отмечено как «Предварительный просмотр». Эти задокументированные возможности не демонстрируют надёжность на ваших файлах.
Почему запуск оказался разочаровывающим
Дебаты сочетали ожидания относительно возможностей с улучшениями эффективности. В объявлении о запуске Google также говорилось, что Gemini 3.5 Pro на тот момент все еще тестировался с партнерами. Это исторический контекст, а не совет по текущей доступности.
Определите, что означает обновление, прежде чем читать его объявление. Для конвейера документов это может означать меньше несопоставленных полей. Для кода агента это может означать меньшую корректную разницу. Для интерактивного помощника задержка ответа может иметь большее значение. Номер версии не предоставляет никаких таких правил принятия.
Попробуйте сравнение агента на 20 задачах
Это авторское упражнение, а не воспроизведённый эталон. Используйте синтетические или утверждённые входные данные, рабочее пространство для экспериментов и обычные настройки одобрения инструментов. Выберите вашу текущую модель и одного доступного кандидата; не изменяйте маршрутизацию на производство во время теста.
- Заморозьте задачи. Выберите 20 репрезентативных задач перед запуском любой модели. Для кодирования включите небольшие исправления, добавление теста, обновление документации и неоднозначный запрос. Используйте одни и те же исходные файлы для обоих кандидатов.
- Сначала определите успех. Для исправления требуйте ожидаемое поведение, успешное прохождение соответствующего теста, отсутствие посторонних изменений и отсутствие вымышленных заявлений о проверке. В случае неоднозначности требуйте уточнение вместо предполагаемого требования.
- Запишите настройку. Сохраните идентификатор модели, поставщика, версию SDK или CLI, подсказку, настройки размышлений, разрешения, тайм-аут и лимит повторов. Используйте свежие сессии. Записывайте различия там, где настройки не взаимозаменяемы.
- Установите бюджет. Выберите максимально допустимые расходы и тайм-аут, которые вы можете себе позволить. Считайте неудачные вызовы и повторы. Остановитесь на лимите и отмечайте случай как неудачный, вместо того чтобы silently предоставлять дополнительные попытки.
- Делайте независимую проверку. Просмотрите каждое различие и выполните его проверку самостоятельно. Отдельно записывайте время работы модели/инструмента и время проверки человеком. По возможности скрывайте названия моделей во время проверки, чтобы уменьшить предвзятость.
Используйте одну строку для каждой задачи и модели:
task_id, model_id, settings, accepted, failure_reason,
attempts, elapsed_seconds, review_minutes, total_api_and_tool_cost_usd
Рассчитайте это после проверки всех задач:
Коэффициент принятия = принятые задачи / попытки выполнения задач
Стоимость за принятую задачу = общие затраты на выполнение, включая неудачные попытки / принятые задачи
Минуты рецензирования на одну принятую задачу = общее количество минут рецензирования / принятые задачи
Если ничего не прошло, укажите ноль принятых задач и оставьте меры на принятые задачи неопределёнными. Укажите медианное и наибольшее зафиксированное время выполнения вместе с неудачами; среднее значение может скрыть остановившегося агента. Упражнение из 20 задач — это отправная точка, а не универсальный рейтинг. Повторите неопределённые случаи перед миграцией и сохраняйте существующий маршрут до тех пор, пока кандидат не выполнит ваши письменные критерии.
Проверьте ошибки миграции перед оценкой качества
Google Руководство по миграции для конкретной версии, обновлено 13 октября, документирует эти проверки интеграции:
| Старая конфигурация или симптом | Проверить перед повторным запуском |
|---|---|
temperature, top_p или top_k предоставлено | Руководство говорит, что они устарели и игнорируются в версии 3.6; удалите их, а не рассматривайте как активные элементы управления. |
| HTTP 400 после префикса помощника | Последний непустой ход модели не допускается. Переместите требования к формату в инструкции или конфигурацию поддерживаемого структурированного вывода. |
thinking_budget предоставлено | Контрольный список заменяет его на thinking_level, перечисляя medium или high для 3.6. |
candidate_count предоставлено | Удалите это; руководство указывает, что в Gemini 3 и более поздних версиях это не поддерживается. |
Это проверки, подтвержденные документацией, а не интеграция, которую мы выполняли. Сохраняйте исходную ошибку и меняйте только одну настройку за раз. Сохраняйте видимость неудачных попыток интеграции, но различайте их от неправильного ответа на корректный запрос.
Кто должен использовать её
Команды, уже использующие Flash 3.6, могут использовать это упражнение, чтобы решить, оправдано ли его сохранение. Новые пользователи также должны изучить более новую модель в каталоге Google и протестировать кандидатов, доступных через их реального поставщика. Возможность API может быть не доступна в каждом приложении или агенте.
Для работы с пользовательским интерфейсом добавьте явные визуальные критерии и проверьте отображаемую страницу. Для извлечения данных проверяйте каждое поле по его источнику. Для работы на компьютере начните с ограниченной задачи и проверяйте последующие действия. Это проверки рабочей нагрузки, а не утверждения о том, что конкретная модель их проходит.
Решение о покупке
Выберите модель, которая соответствует вашему уровню качества при приемлемой общей стоимости и задержке. Сохраните набор задач, сбои, настройки, дату выставления счета и причину для сохранения или изменения маршрута. Пересмотрите решение при изменении цен, версий или вашей рабочей нагрузки.
Продолжайте с выбор места запуска вашей модели для учета хостинга и доступа к данным. Если Gemini CLI игнорирует правила проекта, используйте проверку контекста GEMINI.md перед тем, как приписывать сбой качеству модели.
Источники и проверенные даты
Все проверено 27 октября 2026 года. Даты публикации и обновления документации отличаются от даты этой проверки.
- Объявление о запуске Google: 21 июля 2026 года; оценки поставщиков и контекст запуска.
- Карточка модели Google DeepMind: опубликовано 21 июля 2026 г.; фон модели и ограничения.
- Страница флэш-API Gemini 3.6: обновлено 22 октября 2026 г.; доступность, лимиты и возможности.
- Цены на API Gemini: стандартные тарифы и запланированные изменения; другие уровни указаны отдельно.
- Руководство по миграции Gemini 3.6: обновлено 13 октября 2026 г.; совместимость запросов.
- Оценка запуска Artificial Analysis: 21 июля 2026 г.; собственные исторические измерения оценщика, не тесты Mantis.
- Обсуждение сообщества Gemini: только анекдоты, не техническая проверка или опрос настроений.
Запустите это в работу
Оцените модель на основе вашей рабочей нагрузки, измеряя скорость, стоимость, частоту сбоев и усилия по проверке вместе.
Попробовать
Выполните те же 20 репрезентативных задач на вашей текущей модели и одной альтернативной, затем зафиксируйте принятые результаты и общее время проверки.
Докажите, что это сработало
Опубликуйте набор подсказок, настройки, правила отказа, затраченное время, стоимость и количество принятых результатов, чтобы сравнение можно было повторить.
Где это может оплатить
Для сервиса с поддержкой ИИ лучшая маршрутизация может улучшить производительность или маржу. Меняйте модели только тогда, когда количество выполненных задач это подтверждает.
Держите в поле зрения
- Более высокая пропускная способность может быть важнее выигрыша в бенчмарке для повторяющейся работы с большим объемом.
- Кодирование, мультимодальный анализ, использование компьютера и рабочие нагрузки агентов требуют отдельных тестов задач.
- Полезное сравнение — это стоимость и время на принятый результат, а не только цена или оценка интеллекта.