Кейc продукта · 28 октября 2026
Рабочий процесс AI-агентов кодирования Лорен Тан: доверие превыше всего
Вирусный семинар Лорен Тан учит проверке агентов, оценке навыков и обязательной архитектуре. Создайте рабочий процесс, выходящий за рамки подписи агентов GrokBot.
Доверие растет, когда агенты могут проверять приложение, навыки проходят оценки, а архитектура отклоняет плохие изменения. Доказать один локальный рабочий процесс перед масштабированием.
Вирусные агенты GrokBot обещают готовую автономную компанию. Мастерская Лорен Тан объясняет инженеру что-то более полезное: как заслужить доверие к работе, выполненной агентом. Ее рабочий процесс с агентами по кодированию ИИ соединяет работающее приложение, протестированные навыки и архитектуру, которая отклоняет неподдерживаемые изменения.
В записи Тан на экране идентифицирована как «Инженер-программист | SpaceXAI». Это идентификация в записи, а не независимо проверенная текущая история занятости. 26 октября по HKT, 25 октября по UTC; 27 октября.
Этот анализ основан на полном просмотре 57-минутной записи, двух проходах по расшифровке и на слайдах, показанных на экране. Судя по всему, запись датируется примерно серединой 2026 года, за несколько недель до октябрьских публикаций. Это вывод сделан на основе подсказок на экране: график охватывает июль 2026 года, а Тан описывает текущий месяц как 12-й. Дата записи не подтверждена. Практические адаптации ниже охватывают проверки, оценку навыков и обеспечение соблюдения CI.
Что не так с подписью вирусных агентов GrokBot
Предоставленные полные записи просмотра и оба прохода расшифровок не подтверждают утверждения подписей о структуре организации, принятии или компенсации. Это важно, потому что копирование предполагаемой структуры отчетности не позволит учесть реальную инженерную работу: предоставление агентам доказательств, оценку их процедур и ограничение их изменений.
Проверка фактов: подпись против семинара
Это сравнение охватывает предоставленную полную запись, с двумя проходами по транскрипту и обзором слайдов. Левая колонка пересказывает и , а не цитирует Тана.
| Вирусное утверждение | Что на самом деле говорится в докладе |
|---|---|
| Более 50 агентов GrokBot выполняют работу 20 инженеров | Такой численности или утверждения о замещении нет. Тан описывает концептуальную кривую доверия и сообщает о примерно 20 PR, появившихся за ночь. PR не являются инженерами. |
| 1 начальник штаба, 3 AI PM и более 40 сотрудников выполняют работу за ночь | Семинар не представляет эту иерархию. Он охватывает навыки проверки, подагентов оценки, воспроизведение ошибок в облаке и архитектурные ограничения. |
| Она управляет всей системой за утренним кофе | Она говорит, что проснулась от поступивших PR и проверила их на main. Сцена с управлением кофе — это кадрирование для подписи. |
| 97% инженеров SpaceXAI работают таким образом | На семинаре не указывается процент внедрения по всей организации. |
| Инженеры, использующие эту настройку, получают предложения на сумму более $750 тыс. | Такие данные о компенсации или утверждения о предложениях о найме отсутствуют. |
| 99% людей открывают один GrokBot, задают вопрос и закрывают его | Эта статистика использования отсутствует. Ее критика касается непроверенной работы агентов и слабых инженерных ограничений. |
| Курс за $5,000 заменяется полной системой, построенной с нуля | Цена курса не указана, и это обсуждение мастер-класса с примерами, а не реализация системы, описанной в подписи, от начала до конца. |
Чего она НЕ говорила
Тан не учит этой управленческой иерархии, не добивается внедрения во всей компании, не делает заявление о предложении зарплаты и не продает описанный курс. Мастер-класс не является пошаговой реализацией системы, описанной в подписи. Этот вывод касается именно этой записи, а не всего, что она когда-либо говорила. Отсутствие этих моментов в данной беседе не доказывает самостоятельно, что каждое утверждение в подписи невозможно где-либо еще. Подписи документируют вирусное оформление; они не подтверждают результаты мастер-класса.
Кривая доверия, стоящая за её рабочим процессом с AI-агентами для кодирования
При низком уровне доверия Тан описывает микроменеджмент агента: наблюдение за каждым результатом, проверка его работы и внесение исправлений. Большое количество агентов увеличивает эту нагрузку на надзор. Надежность должна улучшиться, прежде чем полезная автономия сможет развиваться; большее количество агентов само по себе не обеспечивает надежность.
Её кривая представляет собой концептуальное объяснение этого процесса, а не измеренный закон масштабирования и не доказательство того, что она запускает тысячи агентов одновременно. Три рычага изменяют доказательства, доступные для рецензента: проверка с помощью работающего приложения, качественные навыки, улучшенные через оценку, и архитектура, разработанная для вклада агентов.
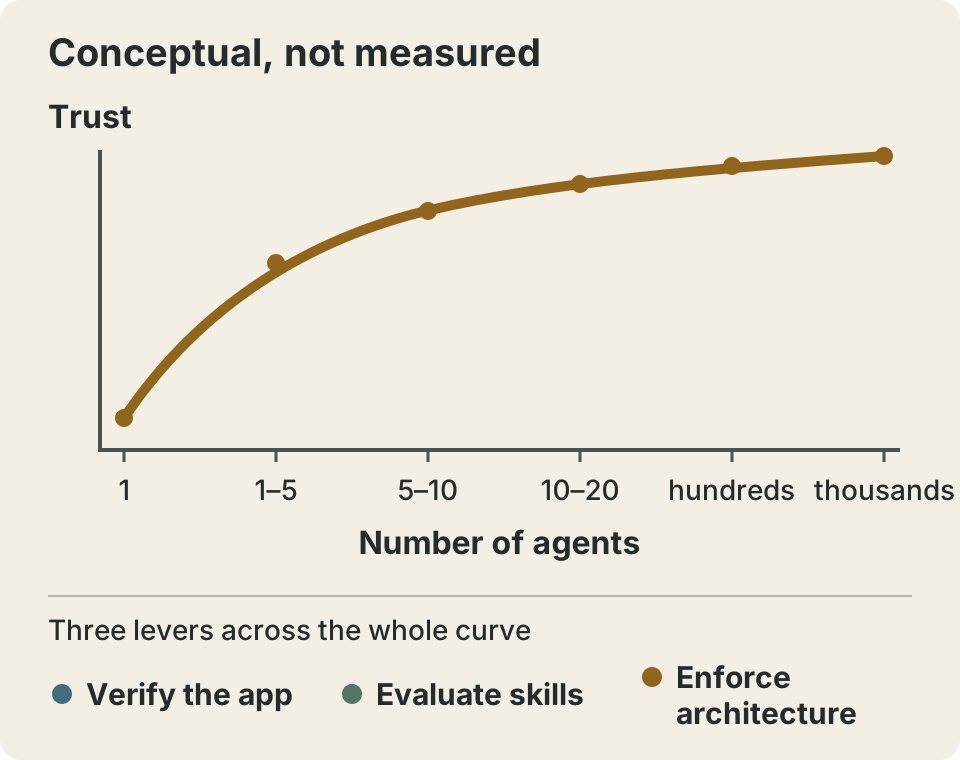
Выходные показатели требуют такого же внимания. Слайд Тан сообщает о более чем 3000 PR за пять месяцев. Она говорит, что в прошлом месяце отправила примерно 1000, описывает около 20 PR, внесённых за ночь, и сообщает о более чем 600 PR, вложенных в рефакторинг архитектуры GrokBot. Это её утверждения, а не результаты независимого аудита пропускной способности. Они перекрываются и не должны суммироваться.
PR также не измеряют замену инженера или качество кода. Тан описывает разные размеры PR и поощряет атомарные изменения, чтобы история оставалась полезной, а регрессии можно было отменить. Малое удаление и серьёзная новая функция каждый могут считаться одним PR. Общее количество коммитов на диаграмме вкладов является отдельной метрикой. Вопрос заключается в том, какие доказательства делают каждое изменение обозримым, а не в том, насколько впечатляюще выглядит совокупный результат.
Для проверки агента требуется запущенное приложение и карта функций
История производительности Тана в первую неделю запуска показывает, почему уверенности агента недостаточно. Столкнувшись с медленным приложением, она собрала трассировки, интерпретировала их и передала доказательства обратно агенту, который уверенно пытался угадать причины. Человек по-прежнему обеспечивал обратную связь. Как она говорит: «Вы — проверяющий». Добавление работников оставило бы это узкое место нетронутым.
Её control-glass навык, показанный как Control Glass через Playwright, управляет сборкой для разработки через Chrome DevTools Protocol. Отображаемые возможности включают инспекцию DOM и доступности, клики, набор текста, скриншоты, трассировки процессора, снимки кучи, наблюдение за консолью и сетью, а также изолированные экземпляры рабочей области. Это показанные возможности, а не публичный рецепт установки, предоставленный записью.
Приложение для запуска позволяет агенту сравнивать ожидаемое поведение с тем, что происходит на самом деле. Оно может отличить правдоподобное исправление от работающего пользовательского потока. Эти доказательства сами по себе не устанавливают поддерживаемость или качество архитектуры: функция может работать, при этом вводя дорогостоящую зависимость или второго владельца состояния.
Напишите навык проверки для одного пользовательского потока
Это Пример Mantis для адаптации проверяет фильтр вымышленной доски проекта. Его маршруты, селекторы и фикстуры должны быть сопоставлены с реальным приложением. Разместите его в каталоге навыков, поддерживаемом вашим инструментом; это не восстановленный навык Тэна.
---
имя: verify-project-filter
описание: Проверьте фильтр "Открытые" на доске проекта в локальной сборке для разработки.
---

# Проверьте фильтр проекта

## Необходимые входные данные
- Путь к репозиторию и точный коммит/сборка, тестируемые в данный момент.
- Подтвержденный локальный URL для разработки и выделенная сессия браузера/CDP.
- Карта функций: docs/features/project-filter.md.
- Создан тестовый аккаунт с одной открытой задачей и одной закрытой задачей.
- Доступные инструменты браузера для инспекции DOM, кликов и скриншотов.

## Процедура
1. Прочитайте карту функций и соответствующую реализацию перед тем, как предполагать причину.
2. Подтвердите, что запущенная сборка, URL и браузер принадлежат этой тестовой среде.
3. Откройте доску с фильтром All. Запишите заголовки обеих контрольных задач.
4. Выберите Open. Подтвердите, что открытая задача осталась, а закрытая задача исчезла.
5. Перезагрузите. Подтвердите, что Open все еще выбран и виден тот же результат.
6. Переключитесь обратно на Все. Подтвердите, что обе задачи возвращаются.
7. Сохраните скриншоты и вывод консоли вместе с коммитом и точными шагами.
8. Для предложенного исправления воспроизведите на базовой версии и повторите на изменённой сборке.

## Вердикт
Верните PASS, FAIL или BLOCKED с ожидаемым/наблюдаемым поведением и путями к артефактам.
Отсутствующий аккаунт, селектор, инструмент или фиксмерие считается BLOCKED, никогда PASS.
Не делайте вывод о успешности по сборке или сообщению об окончании работы агента.
Не меняйте фиксмерие или критерии приёмки, чтобы тест прошёл.

## Границы
Используйте только тестовые данные и предназначенный браузер для разработчиков. Не используйте личные сессии.
Не сливайте, не публикуйте, не удаляйте посторонние данные и не меняйте учётные данные.
Остановитесь после двух неудачных попыток воспроизведения и сообщите, что отсутствует.
Один файл Markdown не предоставляет никаких инструментов CDP. Предоставьте привязки к запуску приложения, проверке состояния и инструментам браузера из вашего проекта, включая выделенную тестовую среду и настройку учетной записи. Не придумывайте универсальную команду control-glass. Явный ожидаемый результат, артефакты до/после и честный вердикт BLOCKED делают процедуру аудируемой. Отсутствие доступа является доказательством неполного запуска, а не разрешением предполагать успех. Доказательства CPU и heap относятся к исследованию производительности; эта проверка фильтра требует наблюдаемых строк и сохранения данных.
Дайте агенту карту функций, по которой он сможет ориентироваться
Доступ к инструменту по-прежнему оставляет проблему со словарным запасом. Отчет о боковой панели или скриншот может не указывать исходный файл. Карта функций соединяет названия интерфейсов, предусловия, маршруты, стабильные селекторы, ярлыки и владельцев исходного кода, чтобы агент мог попасть в нужный поток перед изменением кода.
# Доска проекта: Открытый фильтр

Цель: показать незавершенные задачи без потери выбранного фильтра при перезагрузке.
Маршрут: /projects/demo/board
Предусловия: локальная тестовая учетная запись; подготовленные задачи Open sample и Closed sample.
Исходное состояние: Все выбрано; обе примерные задачи видны; модальное окно не открыто.

Навигация: Проекты -> Demo -> Доска -> Фильтр по статусу.
Ярлык: для этого примера не определен.
Элементы управления: [data-testid="status-filter"] с опциями Все и Открытые.
Строки: [data-testid="task-row"]; идентифицируйте каждый элемент по видимому заголовку.
Ожидаемое: Открытые скрывают закрытые образцы; перезагрузка сохраняет Открытые; Все восстанавливает оба.

Ввод кода: src/features/project-board/ProjectBoard.jsx
Владелец состояния: src/features/project-board/filter-store.js
Прочтите текущую реализацию перед редактированием; эти пути служат навигационными подсказками.
Доказательства: скриншоты до/после, вывод консоли, SHA сборки и наблюдаемые строки.
Обслуживание: обновляйте эту запись при изменении маршрутов, селекторов или поведения фильтров.
Держите карту рядом с развивающимся пользовательским интерфейсом и обновляйте её при изменении навигации или поведения. Она направляет исследование, а не заменяет текущий исходный код. Устаревший селектор должен вызывать проверку, а не предполагаемый вердикт. Тан описывает навыки create-verification и maintain-verification в pstack для создания и поддержания этого контекста; в докладе здесь не предоставляется команда для установки.
Просматривайте центр навыков и набор инструментов навыков агента Hermes в зависимости от задачи инженера, которую выполняет каждый навык. Выберите процедуру, которая закрывает конкретный пробел в доказательствах, затем проверьте её поведение в своей среде.
Оцените навык перед тем, как доверять его вердикту
«Эвалы — это способ модульного тестирования ваших навыков, по сути», — объясняет Тан. Она описывает, как pstack постепенно растет от наблюдаемых ошибок: угадывая причины, не читая соответствующий код и объявляя успех без подтверждающих доказательств. Превращение этих ошибок в инструкции — это только первый шаг. Следующий шаг — проверка того, изменяет ли инструкция поведение.
В ее подходе координатор определяет рубрику, субагенты выполняют изолированные случаи, а судья другой модели перекрёстно проверяет результаты. Нейтральные названия каталогов — это ее тактика для уменьшения подсказок при оценке, а не доказательство того, что осведомленность о оценке исчезает. Тестирование на разных моделях проверяет, переносится ли поведение навыка за пределы первоначального исполнителя.
Тан описывает использование /loop «Продолжать цикл на этом оценивании» до цели 10/10. Эта цель требует проверки. Судья может указать на ошибки работника, а идеальный балл может отражать простую рубрику. Сохраняйте доказательства, которые позволят кому-то оспорить оценку.
Запустить ограниченный цикл оценки
Этот протокол координатора Mantis добавляет предел цикла и бюджет; эти ограничения не являются утверждениями о конфигурации Тана. Это подсказка для адаптации, а не исполняемый код или обещание, что ваша оболочка имеет конкретную команду.
Оцените verify-project-filter по фиксированной рубрике.
Бюджет: не более 3 раундов улучшений, 2 параллельных работника и 30 минут всего.
Остановитесь, когда будет достигнут любой предел. Сообщайте фактическое использование; не повторяйте бесконечно.

Перед запуском:
- Заморозить сломанную установку, где «Открыто» по-прежнему показывает закрытую задачу.
- Заморозить рабочую установку, где фильтр «Открыто» работает корректно и сохраняется после перезагрузки.
- Зарезервировать третью установку с отсутствующими тестовыми данными; ожидаемый вердикт — ЗАБЛОКИРОВАНО.
- Разместить ключи ответов и отложенный случай вне доступа работников.
- Назначить нейтральные имена рабочим пространствам. Дать работникам одинаковые инструкции по задачам.

Каждый раунд:
1. Запускать независимые субагенты в отдельных копиях и сессиях браузера.
2. Сохранять их журналы инструментов, скриншоты, вердикты, ID сборок и время выполнения.
3. Проверять ожидаемые вердикты и видимые строки задач детерминированно.
4. Пусть судья другой модели оценивает артефакты по замороженной рубрике.
5. Если случай неудачен, пересмотрите только навык по наблюдаемым доказательствам неудачи.
6. Повторно выполните учебные случаи; зафиксируйте изменения в пересмотре и оценках.

Принятие кандидата: каждый учебный случай набирает 10/10 без серьезных ошибок.
Затем один раз запустите нетронутый холдаут с замороженным навыком кандидата.
Если холдаут не удастся, сообщите о сбое и разработайте новую оценку перед повторной попыткой.
Оценка 10/10 является результатом на этих случаях, а не сертификацией для производства.
Оцените пять критериев по шкале от 0 до 2: правильная рабочая среда/сборка и предварительные условия; реальная навигация и воспроизведение; сравнение ожидаемого и наблюдаемого, включая перезагрузку/восстановление; прослеживаемые артефакты и достоверный вердикт; соответствие объему и правильная остановка. Ноль означает отсутствие или ошибку, один — частичное выполнение, два — полное и подтвержденное. Для намеренно заблокированного случая полная оценка означает идентификацию отсутствующего предварительного условия и остановку.
Подделка доказательств, проверка неправильной сборки или мутация вне объема считаются серьезной ошибкой независимо от общей суммы. Судья не может отменять детерминированные ошибки. Сохраняйте ответы и отложенные случаи вне досягаемости работников через фактическую изоляцию процессов/файлов; одной лишь соседней директорией безопасность не обеспечивается.
Отдельные проверки вердиктов, идентификаторов сборок и видимых строк из суждений модели о качестве объяснений. Оставьте одну нетронутую контрольную выборку, сравните прогоны с навыком и без него, если это позволяет стоимость, исследуйте неудачи и исправляйте навык, а не ключ ответов. стартовый стек навыков помогает поддерживать небольшое внедрение; лаборатория обзора рабочей области предоставляет соответствующие рекомендации по отдельным чек-аутам и артефактам обзора. Рабочие области изолируют изменения, а не разрешения или секреты.
Dune делает поддерживаемое изменение легким изменением
«Дюна» — это кодовое имя Тан для GrokBot в архитектуре: это соглашения и принципы, а не обещанный публичный пакет. Здесь нет рецепта установки, который можно было бы скопировать. Её беспокойство заключается в том, что прототипные сокращения накапливаются в общую сложность, что делает каждое последующее изменение труднее для оценки. Существующий «brownfield»-код с сильными соглашениями может требовать целевых улучшений, а не переписывания; работа «greenfield» нуждается в ранних ограничениях.
Пять принципов на её слайде описывают конкретное направление. Поддерживаемый маршрут должен требовать меньше решений, чем сокращение. Запрещённые зависимости должны автоматически приводить к сбою. У каждого долговременного значения должен быть один ясный владелец, который его записывает. Новые функции должны добавлять изолированные файлы, а не ветви в общих корнях. Исключения должны быть небольшими, явными архитектурными решениями, подлежащими проверке.
Совмещённый каталог функций предоставляет агентам рабочее пространство с узнаваемыми точками входа и карточками транскриптов. Разделение main/renderer в Electron позволяет исключить дорогие операции из рендерера и защищает его бюджет кадров примерно в 16 мс. Архитектура упрощает выявление правильного владения и облегчает отклонение неподдерживаемых импортов. По выражению Тана, «короткий путь — это лучший путь».
Пять уровней принуждения, от мягкого к жёсткому
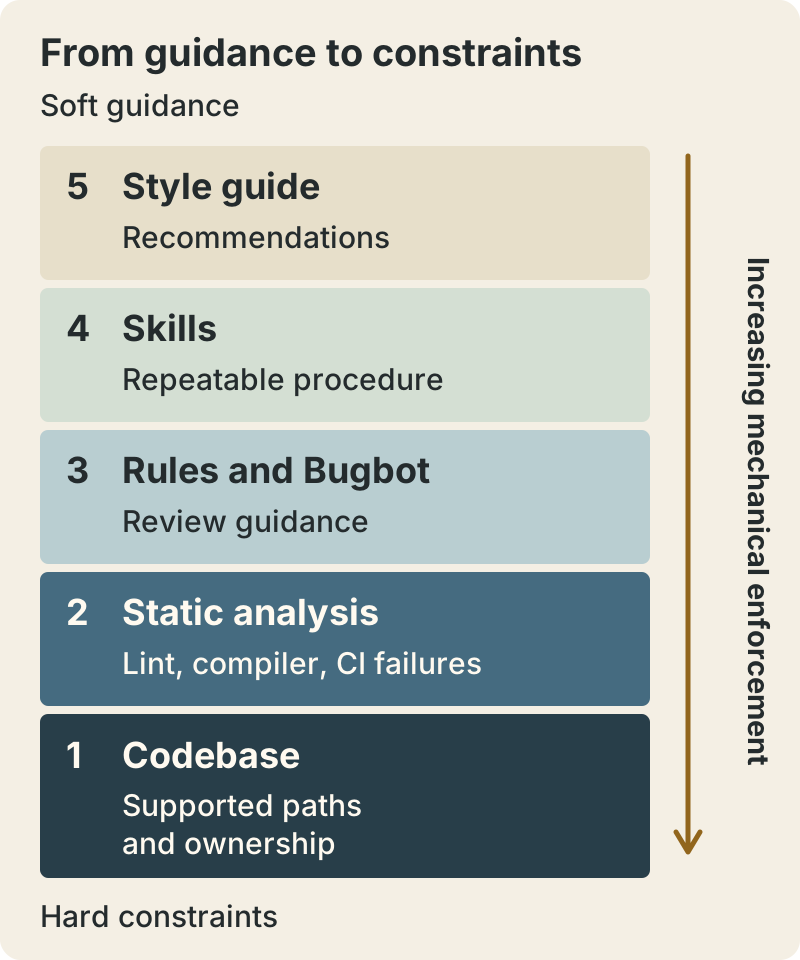
Стек меняет порядок отображения пронумерованных слайдов: руководство по стилю (5), навыки (4), правила/Bugbot (3), статический анализ, включая lint/компилятор/CI (2) и архитектура кодовой базы (1). Эти уровни дополняют друг друга. Мягкие инструкции могут быть забыты; механическая ошибка требует изменения кода или конфигурации, а не успокаивающего ответа. Ни архитектура, ни компилятор не делают ошибки невозможными.
Это инженерия конструктора в редакторском смысле: проектирование среды, доказательств и ограничений вокруг модели. относится к контексту другого автора, @0xwhrrari. Это не письменное руководство Тан или доказательство её заявленных итогов PR.
Превратить один повторяющийся комментарий к проверке в сбой CI
«Как мне превратить это в правило линтинга? Как мне превратить это в сбой CI?» — спрашивает Тан. Её запреты на useEffect и комментарии к коду являются специфичными для проекта решениями, а не универсальными рекомендациями по React или документации. Она описывает случаи, когда агенты добавляют нерелевантное историческое повествование в комментарии. Полезная адаптация заключается в том, чтобы выявить повторяющуюся ошибку и закодировать проверку с ясной поддерживаемой альтернативой.
Сделать, чтобы запрещённый шаблон React вызывал ошибку линтера
На наглядном примере запроса на ревью указывается, что эта функция рендерера должна использовать утверждённого владельца состояния, а не добавлять эффекты. Следующий пример Mantis предполагает проект JavaScript/JSX React с локально установленным и зафиксированным ESLint и плоской конфигурацией. Адаптируйте существующую конфигурацию; сохраните настроенный парсер TypeScript для TypeScript. Этот минимальный пример охватывает только JS/JSX.
// eslint.config.mjs: добавьте эту политику в конфигурацию примера приложения.
экспорт по умолчанию [
  {
    файлы: ["src/renderer/**/*.{js,jsx}"],
    параметрыЯзыка: {
      ecmaВерсия: "последняя",
      типИсточник: "модуль",
      параметрыПарсера: { ecmaОсобенности: { jsx: правда } }
    },
    параметрыЛинтера: { запретитьВстраиваемуюКонфигурацию: правда },
    правила: {
      "запретитьОграниченныйСинтаксис": [
        «ошибка»,
        {
          селектор: "ImportDeclaration[source.value='react'] > ImportSpecifier[imported.name='useEffect']",
          сообщение: "Используйте утвержденного владельца состояния функции; функции отрисовщика не могут импортировать useEffect."
        },
        {
          селектор: "CallExpression[callee.name='useEffect']",
          сообщение: "Используйте утвержденного владельца состояния функции вместо эффекта отрисовщика."
        },
        {
          селектор: "CallExpression[callee.type='MemberExpression'][callee.property.name='useEffect']",
          сообщение: "Используйте утвержденного владельца состояния функции вместо эффекта отрисовщика."
        }
      ]
    }
  }
];
Сбойный тест, src/renderer/policy-fail.jsx:
импорт { useEffect как runEffect } из "react";
экспорт функция Статус() {
  runEffect(() => {}, []);
  вернуть null;
}
Успешный тест, src/renderer/policy-pass.jsx:
экспорт функция Статус({ метка }) {
  вернуть <вывод>{label}</вывод>;
}
Выполните каждую команду отдельно в отдельном проекте:
./node_modules/.bin/eslint src/renderer/policy-fail.jsx --max-warnings 0
./node_modules/.bin/eslint src/renderer/policy-pass.jsx --max-warnings 0
Ожидаемые завершения: 1 с сообщением import-policy для ошибки и 0 для успеха. Выход 2 означает проблемы с конфигурацией/временем выполнения. Документация правила селектора ESLint объясняет селекторы и пользовательские диагностические сообщения; её документация CLI охватывает флаги и коды выхода.
Селектор импорта ловит псевдонимы, такие как runEffect. Вызовы селекторов охватывают прямые и членские вызовы, но обертки, повторный экспорт, вычисляемый доступ по строке и необычные импорты требуют дополнительного контроля. Универсальный селектор членов может пометить метод, не относящийся к React. Это правило синтаксиса, а не всесторонний анализ символов.
Проверьте оба фикстуры, затем удалите умышленно неудачный файл из производственного кода. Запустите существующую обязательную CI/сборку ./node_modules/.bin/eslint src/renderer --max-warnings 0 перед сборкой. Распространяйте ошибку с помощью && или быстрого выполнения; защищайте изменения конфигурации через ревью. Укажите в диагностике реально поддерживаемый API. Этот пример не реализует ни этот API, ни запрет комментариев. Здесь только содержание статьи: Mantis не добавляет зависимость ESLint, скрипт или воркфлоу; GitHub Actions отключен.
Начните локально, затем перенесите проверенную работу в облако
«Я думаю, что лучше всего начинать с местного уровня, потому что вы можете наблюдать». Совет Тана даёт вам возможность инспектировать вызовы инструментов и поведение приложения, корректируя навык. Если агент откроет неправильную сборку, пропустит предусловие или примет состояние загрузки за успешное выполнение, вы сможете заметить ошибку до того, как автоматизируете её в другом месте.
После подтверждения этого цикла используйте проверенную среду и навык в облаке. Пример Бенни от Тана обрабатывает отчёты об ошибках, запускает собственный облачный рабочий стол, управляет Курсором с теми же навыками управления и воспроизводит поведение. Полезным результатом было то, что отчёт воспроизводился на старой сборке, хотя, по её словам, «это уже исправлено в основной версии». Оставшимся действием было выпуск ещё одной сборки. Бенни не нужно было создавать дубликат исправления, и пример не утверждает, что он написал первоначальное исправление.
Идентификаторы сборки и окружения являются важными доказательствами. Записывайте указанную версию, протестированный коммит, состояние фикстуры и точные шаги вместе со скриншотами или записями. Различайте воспроизведенные, не воспроизведенные, уже исправленные и заблокированные результаты. Отчет без воспроизводимого окружения должен оставаться заблокированным до получения недостающей информации.
Тан также описывает, как PM, дизайнеры и коллеги из GTM вносят свой вклад в рамках ограниченной системы. Это человеческие коллеги. В примере с PM она все еще описывает проверку предложенного исправления. Практическая польза в том, что участники могут следовать поддерживаемым путям и предоставлять доказательства для проверки; сообщение о завершении агента не снимает эту ответственность.
Скопируйте цикл обратной связи в рамках вашего лимита токенов
«Я работаю в лаборатории ИИ, где у нас неограниченное количество токенов», — говорит Тан, прежде чем предостеречь от копирования её точного подхода. Она описывает значительные первоначальные расходы токенов и компромиссы по ROI. Её доступ не означает, что та же самая рефакторизация или график оценки подойдут бюджету другой команды.
В первую неделю используйте одного агента и один поток. Напишите одну запись в карту, соберите пакет доказательств и убедитесь, что вы можете отличить рабочий запуск от сломанного. Добавьте фикстуры для сломанного и рабочего оценивания, с удержанием при пропавших данных, которое должно возвращать BLOCKED. Затем превратите одну повторяющуюся неудачу проверки в обязательную проверку. Перенесите только задачу стабильно воспроизводимого запуска в облачную среду после того, как она надежно начнёт возвращать доказательства.
Явно учитывайте повторные попытки бюджета и параллельных работников. Останавливайтесь, когда достигнут лимит времени или расходов, и честно фиксируйте незавершённую работу. Измеряйте стоимость за проверенную задачу, время обзора и регрессии вместе с количеством выполненных задач. Более дешёвое выполнение, требующее длительного ручного расследования, может быть худшим результатом; заблокированное решение, которое предотвращает неправильное исправление, может быть ценным.
С Ранний обзор Astra является связанной литературой по ограниченной проверке, а не подтверждающим доказательством для этого воркшопа. Перед расширением рабочего процесса используйте урок проверки принятия чтобы определить доказательства, которые позволят рецензенту принять следующее изменение.
Источники воркшопа и практические ссылки
Источники: , , отдельную , и официальная документация селектора ESLint и CLI Документы и схемы являются адаптациями Mantis. Шаблоны проверки плат представляют собой иллюстративные материалы и не были протестированы на реальном приложении; два настраиваемых примера линтинга были проверены в временном проекте и вернули ожидаемые коды завершения успеха и ошибки.
Запустите это в работу
Отделите вирусную подпись от рабочего процесса Лорен Тан по завоеванию доверия в кодирующих агентах.
Попробовать
Напишите один навык проверки, сопоставьте одну функцию и оцените её на неисправном и рабочем примере.
Докажите, что это сработало
Сохраняйте доказательства воспроизведения, оценивайте по установленной шкале и демонстрируйте проверку CI, отклоняющую известное нарушение.
Держите в поле зрения
- Вирусная организационная схема и претензии по компенсациям не появляются на мастер-классе.
- Навык проверки и карта функций позволяют агентам тестировать приложение, которое они изменяют.
- Оценки навыков и принудительная архитектура упрощают повторную проверку работы.