Исследование
Бывшие сотрудники DeepMind запускают Faraday Agent для автоматизации воспроизведения научных статей
Стартап Inherent, основанный бывшими исследователями Google DeepMind, разработал агент ИИ под названием Faraday, который, по заявлению компании, превосходит системы Anthropic и OpenAI в воспроизведении экспериментальных результатов из опубликованных научных статей. Этот инструмент решает постоянную проблему в исследованиях: проверку того, могут ли опубликованные результаты быть независимо воспроизведены.
Майкл Г ·
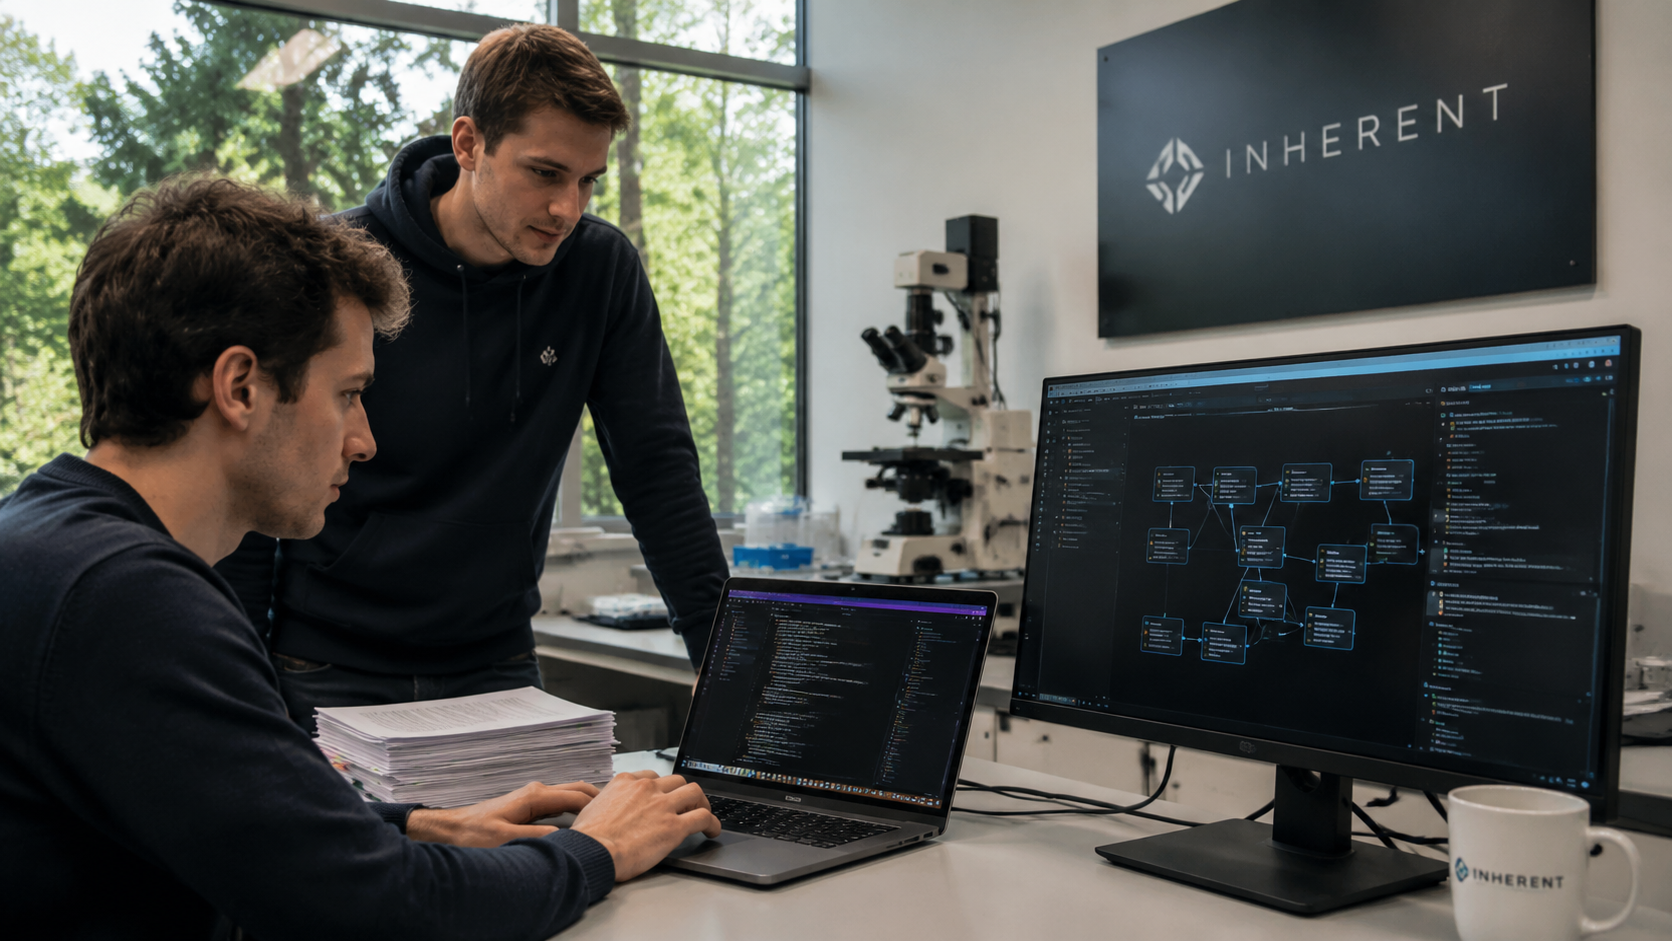
Воспроизведение научных результатов остаётся одним из самых трудоёмких узких мест в этой области. Когда исследователи публикуют свои результаты, их проверка часто требует месяцев работы: обратной разработки экспериментальных установок, поиска наборов данных, которые могут быть защищены авторским правом или утрачены со временем, восстановления программной среды по скудной документации и отладки кода, написанного авторами, которые могут больше его не поддерживать. Inherent, основанная бывшими исследователями Google DeepMind, утверждает, что её агент Faraday может автоматизировать большую часть этой работы. Согласно отчету TechCrunch, компания заявляет, что Faraday превзошёл сопоставимые системы Anthropic и OpenAI в воспроизведении результатов научных статей в различных областях.
Фокус стартапа отражает настоящую кризисную ситуацию в академических публикациях. Исследования за последнее десятилетие показывают, что многие опубликованные результаты не могут быть воспроизведены независимыми командами. Некоторые неудачи связаны с неполной документацией. Другие возникают из-за тонких зависимостей между кодом, данными и вычислительными средами, о которых авторы никогда не думали, что они будут иметь значение. Еще одни показывают отрицательные результаты: эксперименты, которые работали при определенных условиях, но терпят неудачу, когда параметры меняются. Faraday решает эту проблему, рассматривая воспроизведение статьи как структурированную инженерную задачу. Агент читает опубликованные статьи, извлекает методологические детали, ищет связанный код и наборы данных, восстанавливает среды и пытается полностью провести эксперименты. Когда ему это удается, исследователи получают уверенность в том, что результаты являются достоверными. Когда это не удается, конкретная точка сбоя часто выявляет, вызвана ли проблема отсутствием данных, недокументированными зависимостями среды или фактическими проблемами с оригинальной работой. Отчет TechCrunch документирует материалы, лежащие в основе этого отчета.
Здесь важно различать воспроизведение кода и научную валидацию. Faraday может выполнять код и воспроизводить численные результаты. Это отличается от независимой проверки научного вывода. Код из статьи может идентично работать на другой машине, но при этом делать выводы, которые не полностью поддерживаются данными, или не учитывать факторные переменные, которые была бы выявлены при независимой репликации. То, чем занимается Faraday, — это инженерный уровень: практическая, трудоемкая работа по запуску опубликованного кода в новом контексте. Этот уровень достаточно значителен, чтобы его автоматизация создавала реальную ценность как для исследовательских команд, так и для платформ публикаций.
Узкое место репликации
Скрытые данные представляют собой одно из самых сложных препятствий для воспроизведения. В статьях иногда используются проприетарные наборы данных, медицинские записи, защищённые законами о конфиденциальности, или внутренние корпоративные данные, которые нельзя публиковать. Авторы могли обучаться на статьях arXiv или других открытых источниках, но точные версии наборов данных со временем изменяются по мере обновления или удаления файлов в репозиториях. Код может ссылаться на локальные пути к файлам или жёстко заданные учетные данные, удалённые перед публикацией. Faraday не может создать отсутствующие данные, но может определить, чего не хватает, и явно это указать. Этот диагностический шаг сам по себе экономит исследователям недели тупикового отладки. Агент узнает, какие пробелы фатальны для воспроизведения, а какие можно обойти. Он также различает случаи, когда авторы действительно предоставили недостаточную информацию, и случаи, когда необходимая информация существует в дополнительных материалах, репозиториях GitHub или блогах, опубликованных автором, на которые сама статья не ссылается. Врождённый предоставляет полезную техническую информацию для оценки этого утверждения.
Восстановление среды также играет важную роль. Статья, опубликованная пять лет назад, могла зависеть от конкретных версий библиотек машинного обучения, выпусков Python, драйверов GPU или операционных систем. Часто эти версии больше не совместимы друг с другом. Деревья зависимостей изменились. Патчи безопасности нарушили работу старых API. Faraday должен ориентироваться в этом археологическом слое, рассуждая о совместимости версий, определяя вероятные пути замены и проверяя, могут ли современные библиотеки воспроизвести исходные численные результаты. Некоторые эксперименты чувствительны к аппаратному обеспечению: округление чисел с плавающей запятой, поведение кэша ЦП, различия в архитектуре GPU или инициализация случайного семени. Faraday необходимо учитывать эти физические ограничения и сообщать, когда результаты расходятся из-за аппаратных особенностей, а не метода. Операционная компромиссность также отражена в Google DeepMind.
Заявления компании о бенчмарках основаны на собственных тестах Inherent. Конкретные статьи, метрики и конкурентные системы остаются конфиденциальными. Это не аннулирует заявления, но означает, что исследовательское сообщество не может независимо проверить численные значения без доступа к тестовому набору и методологии Inherent. Оценка третьей стороной потребовала бы от исследователей запуска Faraday, других агентов от Anthropic и OpenAI, а также систем для сравнения на общем наборе статей с измерением успеха по единым критериям. Эта работа не была опубликована по состоянию на август 2026 года. Компания Inherent создала инструмент и продемонстрировала его ранним пользователям и представителям прессы, что поддерживает достоверность базовой функциональности. Оценка величины разрыва в производительности требует внешнего воспроизведения. Компания опубликовала веб-сайт, описывающий продукт, но подробная техническая документация по архитектуре Faraday, подходу к обучению и ограничениям остаётся ограниченной. Для более широкого контекста, arXiv описывает соответствующий стандарт или учреждение.
Последствия для публикаций и исследований
Если Faraday будет работать надежно в масштабе, этот инструмент может изменить подход журналов к воспроизводимости. Некоторые издатели начали требовать от авторов предоставления кода и данных вместе со статьями. Другие проводят базовые проверки представленного кода перед его принятием. Автоматический агент, который способен воспроизводить опубликованные результаты в момент публикации или вскоре после неё, предложит новый механизм контроля. Журналы могли бы использовать успешное воспроизведение как критерий в процессе рецензирования или пост-публикационной оценки. Исследователи, цитирующие статью, могли бы узнать, удалось ли Faraday успешно её воспроизвести. Финансовые организации могут потребовать, чтобы получатели грантов демонстрировали воспроизводимость своих опубликованных результатов с использованием такого инструмента. Эти шаги вызывают собственные вопросы: как журналам следует учитывать успех воспроизведения по сравнению с новизной? Следует ли публиковать отрицательные результаты репликации? Следует ли отзывать статьи, которые не прошли репликацию, или частичная репликация сама по себе имеет ценность? Ответы зависят от области, важности и причины неудачи. A статья по машинному обучению код которой не запускается из-за отсутствующего набора данных, все еще может содержать ценные идеи. Результат клинического испытания, который нельзя воспроизвести, может представлять прямую угрозу безопасности. Faraday может автоматизировать техническую работу, не решая эти полисиевые вопросы.
Более широкий контекст здесь заключается в растущей сложности исследований в области машинного обучения. Статьи в этой области теперь регулярно зависят от больших кодовых баз, проприетарных наборов данных, распределённой вычислительной инфраструктуры и коммерческих API. Репликация результата глубокого обучения означает контроль не только кода и данных, но также доступности GPU, времени обучения и эффектов случайной инициализации, которые могут значительно сдвигать результаты. Faraday должен учитывать все эти факторы. Он также должен обрабатывать статьи, которые объединяют машинное обучение с другими областями: статьи по робототехнике, которые зависят от спецификаций физического оборудования, статьи по нейронауке, которые зависят от проприетарных данных сканирования мозга, или статьи по открытию лекарств, которые зависят от библиотек вычислительной химии. Ни один агент не может идеально справляться со всеми случаями. Преимущество Faraday, по словам Inherent, заключается в том, что он превосходит существующие универсальные системы ИИ в этой конкретной задаче. Это может быть связано с целенаправленным обучением, лучшими стратегиями подсказок или встроенным в агента специализированным рассуждением.
Независимая проверка работы Фарадея самим Фарадеем в конечном счете определит её влияние. Научное сообщество должно относиться к заявлениям компании о производительности на бенчмарках с должной осторожностью, особенно когда бенчмарки ещё не являются общедоступными. Важно то, добьётся ли Фарадей успеха, когда его используют реальные исследователи на статьях, которые для них имеют значение, охватывая достаточно разнообразные области и достаточное количество статей, чтобы получить надёжные данные. Ранние пользователи здесь будут критически важны. По мере того как больше исследователей будут использовать Фарадей и сообщать о результатах, станут проявляться закономерности того, с какими типами статей он справляется хорошо, а какие остаются неизменными. Обратная связь пользователей будет формировать как инструмент, так и обсуждение того, как ИИ может ускорять воспроизводимые исследования. На данный момент Faraday представляет собой значительный инженерный прорыв в автоматизации одной из самых раздражающих задач в исследовательской работе. Будет ли он становиться стандартным слоем в научной публикации, зависит от валидации, доступности и устойчивого развития после первоначального запуска.
Темы: Исследования в области ИИ, научная воспроизводимость, машинное обучение, DeepMind, автоматизация