Технологии
Nvidia расширяет своё преимущество в области ИИ-инфраструктуры за пределы GPU к полностью интегрированным стеллажным системам
Конкурентная позиция Nvidia расширяется от отдельных ускорителей к тесно интегрированным системам вычислений, памяти, сетей и хранения данных. По мере того как ИИ-комплексы достигают гигавадтного масштаба, координация перемещения данных и энергоэффективность могут быть так же важны, как и сам GPU.
Патрик Т ·
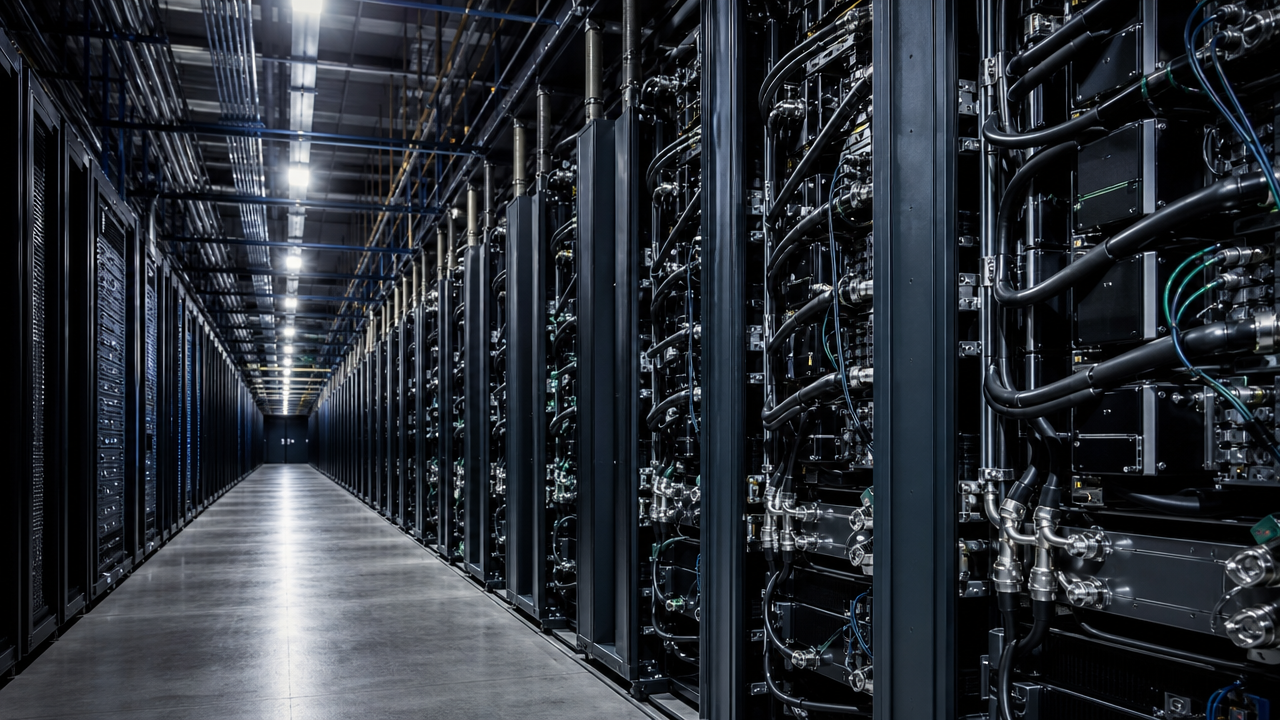
Nvidia расширяет своё преимущество в области инфраструктуры ИИ от ускорителя в центре сервера до полной системы, которая позволяет тысячам ускорителей работать вместе. Платформа Vera Rubin объединяет GPU с CPU, сетевыми компонентами, хранилищем и специализированными компонентами, спроектированными как координированная архитектура стойки. Это изменение важно, потому что самой сложной задачей на крупнейших ИИ-кампусах больше не является получение быстрого чипа в одиночку. Сложность заключается в перемещении состояния модели и обучающих данных через огромную систему без простоя дорогостоящих процессоров и потерь энергии.
Эта стратегия появляется на фоне того, что Amazon, Google и другие гипермасштабируемые компании увеличивают инвестиции в собственные ускорители. Специальный кремний предоставляет облачным операторам влияние на стоимость и поставки, ослабляя предположение о том, что каждая передовая нагрузка должна выполняться на стандартном GPU Nvidia. TechCrunchутверждает, что конкурентная реакция видна вокруг чипа: Nvidia продает больше памяти, межсоединений, сетевых решений и оркестровочного слоя, необходимых для превращения производительности компонентов в работоспособную производительность кластера.
Вера Рубин делает этот системный аргумент явным. Архитектура объединяет GPU Рубин с CPU Веры и интегрированную инфраструктуру на уровне стоек. Модель, параметры, активации и кэш которой не помещаются на одно устройство, должна постоянно обмениваться данными между процессорами и узлами. Каждый обмен вводит задержку и потребляет энергию. Задача системного дизайнера — обеспечить дорогие вычислительные движки правильными данными, минимизируя перемещения, которые увеличивают стоимость без продвижения рабочей нагрузки.
Узкое место перемещается за пределы GPU
В меньшем масштабе покупатели могут сравнивать ускорители, используя знакомые показатели, и настраивать серверы вокруг них. В мегамасштабе локальные сравнения компонентов становятся менее решающими. Топология сети, восстановление после сбоев, пропускная способность хранилища, планирование и размещение памяти определяют, сколько теоретической производительности достигает приложение. Кластер может обладать отличными GPU и при этом демонстрировать плохую экономику, если связь задерживается или программное обеспечение не может эффективно распределять рабочие нагрузки. Вот почему токены на ватт и полезная работа на стойку становятся более важными, чем одно пиковое значение.
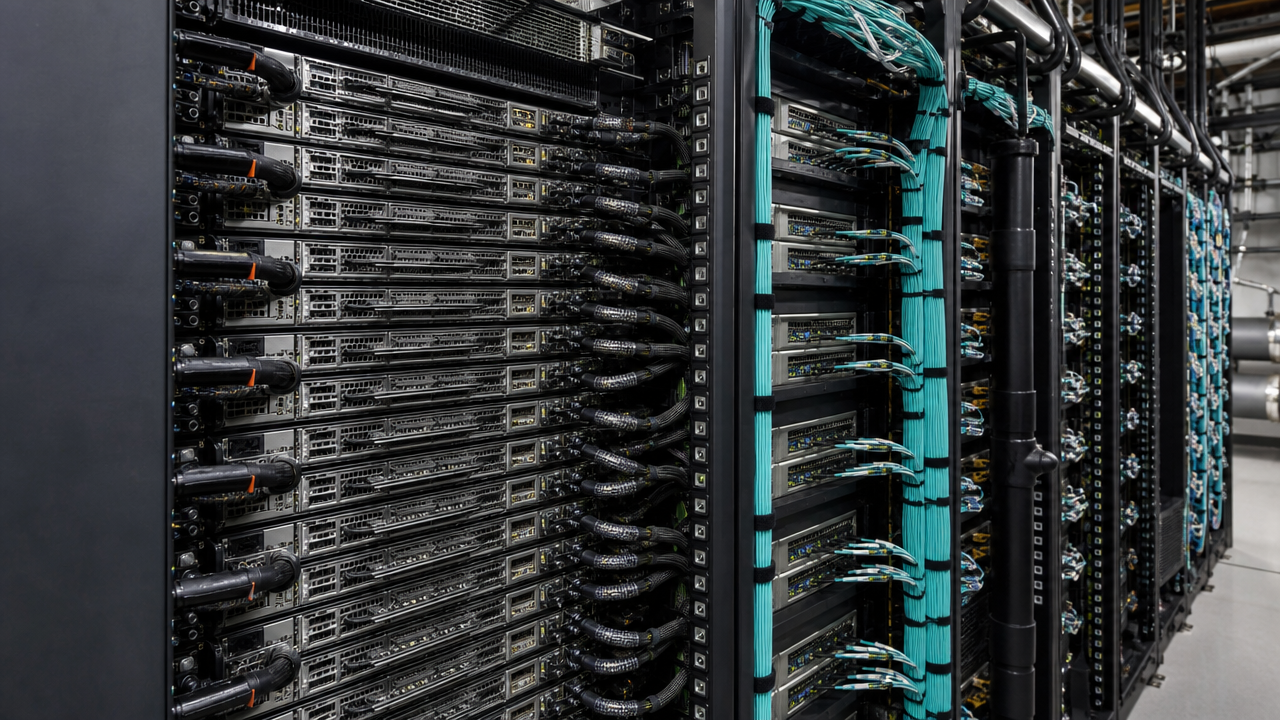
Память иллюстрирует сдвиг. По мере того как модели и окна контекста растут, системам требуется больше высокоскоростной памяти рядом с вычислительными ресурсами и большие объемы данных, доступные по всему кластеру. Поставщики, такие как Micron , извлекли выгоду, потому что спрос на ускорители тянет за собой спрос на память. Операционный вызов заключается в доставке правильных данных в нужное время. Роль процессора Vera отчасти заключается в оркестрации, координации работы, когда ни один сервер не может содержать полное состояние, необходимое для большой задачи.
Сетевые технологии также являются ключевыми. NVLink и связанные с ним технологии коммутации позволяют ускорителям обмениваться данными с пропускной способностью и задержкой, которые обычные сети дата-центров не могут обеспечить. Тесная интеграция может обеспечить более предсказуемую производительность, так как аппаратное и программное обеспечение разрабатываются вместе. Она также создаёт зависимость. Клиент, который строит инфраструктуру вокруг стоек, технологий коммутации и программного обеспечения одного поставщика, не сможет так же легко заменить ускоритель, как это было бы возможно в более модульном сервере.
Эта зависимость не является автоматически неправильным решением. Предприятия регулярно выбирают интегрированные платформы, потому что стоимость разработки каждого интерфейса превышает экономию от гибкости компонентов. В развёртываниях Frontier AI сроки сжаты, а специализированные кадры редки. Проверенный стоечный модуль может снизить риски интеграции и быстрее выйти в производство. Компромисс проявляется позже в переговорах о цене, циклах обновлений и возможности принимать конкурирующий чип без перестройки программного обеспечения и операций вокруг него.
Программное обеспечение превращает интеграцию в рв
CUDA продолжает оставаться значительной частью преимущества Nvidia, потому что разработчики и команды инфраструктуры потратили годы на создание кода, библиотек и операционных практик вокруг него. Платформа поддерживает не только выполнение ядра. Она соединяет профилировщики, коммуникационные библиотеки, фреймворки моделей и инструменты для развертывания. Конкуренты в аппаратном обеспечении могут производить способные ускорители, но клиенты также оценивают инженерную работу, необходимую для переноса и проверки рабочих нагрузок. Эти затраты на миграцию дают Nvidia возможность расширяться от чипов до полных систем.
Пользовательские чипы гипермасштаберов остаются значительным фактором давления. Программа TPU от Google демонстрирует, что облачный провайдер может создать зрелый сервис ускорителей, оптимизированный для собственной инфраструктуры и выбранных рабочих нагрузок. Amazon пошла аналогичным путем. Эти системы не должны повсеместно заменять Nvidia, чтобы изменить рынок. Они могут захватывать внутренние задачи с большим объемом, создавать альтернативные программные экосистемы и предоставлять крупным покупателям ориентировочную цену при переговоре о внешних GPU.
Ответ Nvidia заключается в том, чтобы увеличить единицу конкуренции. Если покупатели сравнивают только производительность ускорителя, альтернативы могут атаковать один компонент. Если сравнение включает пропускную способность стоек, время развертывания, поведение сети, интеграцию хранения и поддержку программного обеспечения, претендент должен соответствовать всей экосистеме. Эта стратегия напоминает бизнес-платформы для крупных предприятий, которые защищают основной продукт, владея смежными слоями. Она может поддерживать маржу при росте спроса, но также поднимает вопросы антимонопольного регулирования и концентрации клиентов, если слишком большая часть стека зависит от одного поставщика.
Операции решат, оправдывает ли платформенный обещание. Плотные стойки создают высокие требования к охлаждению и питанию. Сбой сетевого коммутатора, кабеля или компонента управления может повлиять на гораздо больше вычислительных ресурсов, чем отказ карты в небольшом сервере. Операторам нужна телеметрия, которая выявляет ухудшение состояния до того, как задания завершатся сбоем, резервная мощность для обслуживания и системы планирования, которые могут перемещать работу без потери дорогостоящего прогресса обучения. Интеграция должна улучшать эти задачи, а не просто упрощать закупки.
Тест заказчика — это полезная работа на каждый потраченный доллар
Покупателям следует оценивать полную стоимость рабочей нагрузки, включая приобретение, энергопотребление, сетевые расходы, затраты на инженерное время, простой и срок службы платформы. Nvidia может оправдать более высокую цену, если система быстрее выходит на рабочий режим и эффективнее загружает ускорители. Конкуренты могут выигрывать, если их более низкая стоимость компонентов оправдывает расходы на перенос и эксплуатацию в масштабах. Ни один из этих исходов нельзя определить по спецификации запуска. Для этого требуется измерение производительности приложений в собственной среде клиента.
Планирование емкости также становится проблемой программного обеспечения. Обучающие задачи, интерактивный вывод и пакетные рабочие нагрузки предъявляют разные требования к памяти и сетям. Платформа, которая планирует их разумно, может улучшить использование ресурсов без добавления чипов. Операторам следует выяснить, предоставляют ли инструменты управления достаточно информации для настройки этих решений или скрывают их за слоем, контролируемым поставщиком. Простота ценна до тех пор, пока система ведет себя неожиданно, и инженеры не могут понять, почему.
Открытые стандарты могут смягчить эффект зависимости от конкретного производителя, если они сделают форматы моделей, интерфейсы управления и управление сетью более переносимыми. Оптимизация, специфичная для оборудования, по-прежнему будет иметь значение, поскольку самые крупные рабочие нагрузки чувствительны к небольшим приростам эффективности. Реальная цель заключается не в совершенной взаимозаменяемости. Это сохранение достаточной переносимости, чтобы клиент мог запускать новые рабочие нагрузки на другой платформе без полной перестройки всех своих данных и процессов развертывания.
Устойчивость поставок — еще одна причина, по которой покупатели могут избегать единой архитектуры, даже если она демонстрирует лучшие показатели. Полная стойка Nvidia зависит от более широкого списка материалов и специализированных производственных мощностей. Концентрация может упростить поддержку, но при этом делает сбои более значительными. Крупные клиенты, вероятно, будут поддерживать альтернативные программы ускорителей отчасти в качестве страховки, соглашаясь на некоторое дублирование программного обеспечения, чтобы сохранить переговорное влияние и непрерывность работы.
Системный подход также может сместить конкуренцию в сторону сервисных организаций. Развертывание плотных стоек требует экспертизы в области охлаждения, электропитания, проектирования инфраструктуры и надежности. Nvidia и ее партнеры могут предоставлять эталонные проекты, но каждый объект имеет свои ограничения. Поставщики, которые помогают клиентам быстро достичь стабильной работы, могут захватывать ценность, превышающую продажи компонентов. Этот сервисный уровень предоставляет обратную связь для следующего поколения оборудования и делает платформенное сотрудничество более трудным для разрыва.
Команды по закупкам должны требовать доказательств на уровне рабочей нагрузки, прежде чем распространять выбор платформы на всю инфраструктуру. Обучение, извлечение данных, кодирование агентов и обработка большого объема выводов могут требовать разных характеристик памяти и задержки. Шкаф, который отлично справляется с одной задачей, может быть неоправданно дорогим для другой. Смешанная инфраструктура увеличивает операционную нагрузку, но может предотвратить превращение премиальной архитектуры в стандарт для задач, которые не выигрывают от её сильнейших особенностей.
Финансовые планировщики также должны рассчитывать стоимость следующего обновления. Интегрированные системы могут улучшить текущую эффективность использования, одновременно затрудняя частичное обновление, если процессоры, структуры и ускорители развиваются по разным графикам. Ожидаемый срок службы программного обеспечения и сетей может быть длиннее, чем цикл GPU. Условия контрактов, варианты перепродажи и обратная совместимость определят, смогут ли клиенты сохранить эти уровни или должны будут заменить большую часть стойки для внедрения нового ускорителя.
Следующий этап конкуренции в области AI-инфраструктуры, следовательно, будет больше походить не на тест чипа, а на конкурс промышленных систем. Nvidia делает ставку на то, что накопленный опыт в области программного обеспечения, сетей и проектирования стоек останется ценным, даже когда у клиентов появятся более широкие возможности выбора ускорителей, включая TPU Google Cloud платформа. Нерешённым остаётся вопрос: будет ли интеграция продолжать снижать общие эксплуатационные расходы или станет формой «запирания», стоимость которой растёт быстрее, чем её польза. Клиенты будут отвечать на этот вопрос, внедряя кластеры один за другим.
Темы: Nvidia, Вера Рубин, инфраструктура ИИ, центры обработки данных, сети