Исследование
KVBoost предлагает гибкое повторное использование кэша при выводе LLM без ограничений по позиции
Исследователи представляют двойное хеширование ключей, чтобы позволить повторное использование фрагментов кеша ключ-значение в любом месте запроса, решая основную неэффективность при инференсе крупных языковых моделей. Подход сочетает перемещение кеша с перерасчетом, направляемым отклонениями, для обработки несоответствий границ внимания, хотя независимая проверка производительности пока не проведена.
Майкл Г ·
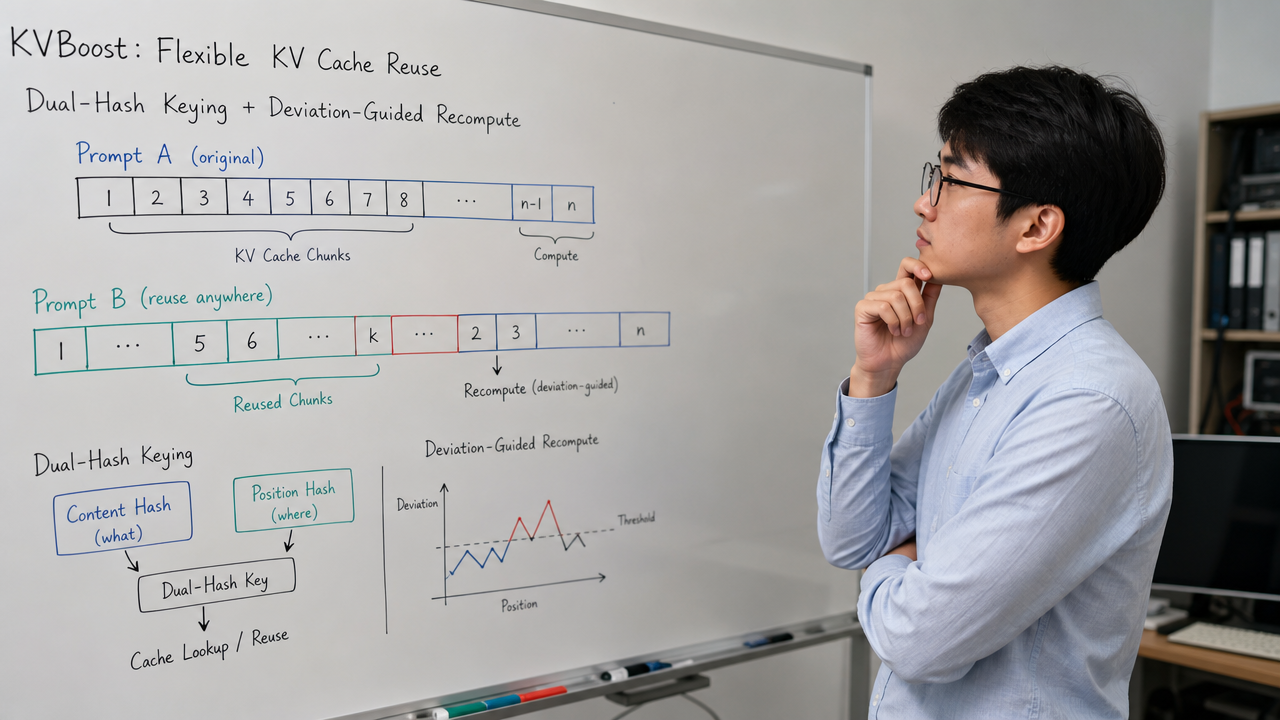
Новое исследовательское предложение нацелено на структурное ограничение в том, как большие языковые модели повторно используют закэшированные вычисления во время вывода. Текущие методы кэширования префиксов закрепляют блоки кэша ключ-значение на фиксированных позициях внутри подсказки, что означает, что повторно используемый сегмент из одного разговора нельзя задействовать раньше или позже в другом без повторного вычисления. В статье KVBoost представлен метод двойного хэширования ключей, который разъединяет блоки кэша от их исходных позиций в подсказке, позволяя одним и тем же закэшированным данным обслуживать несколько путей вывода независимо от того, где они появляются.
Основной технический вклад касается того, что происходит, когда блоки кэша перемещаются. Поскольку внимание трансформера работает с последовательностями, перемещение закэшированного сегмента на новую позицию в подсказке изменяет относительные расстояния и зависимости, которые механизм внимания должен вычислять. KVBoost предлагает перевычисление, управляемое отклонениями, чтобы выборочно пересчитывать значения внимания на границах, где кэшированный блок взаимодействует с новым контекстом, а не пересчитывать всю последовательность. Этот гибридный подход направлен на восстановление корректности без отказа от преимуществ эффективности, получаемой при повторном использовании кэша. Статья KVBoost документирует материалы, лежащие в основе этого отчета.
Исследование описывает механику как управление задержкой предзаполнения и расходами памяти. Во время фазы предзаполнения, когда языковая модель обрабатывает всю входную подсказку перед генерацией вывода, модель строит кэша KV. Если сегменты этого кэша могут быть перемещены и повторно использованы в разных подсказках, вычисления предварительной загрузки сокращаются. Компромисс заключается в объеме памяти, необходимой для хранения индексов с двойным хешированием, и стоимости выборочного перерасчета на границах блоков. Нагрузки с повторяющимся несмежным содержимым, такими как документы с типовыми разделами, чередующимися с уникальными материалами, теоретически получают наибольшую выгоду от повторного использования кэша с гибким положением.
Проверка и область производительности
Исследователи представляют KVBoost как демонстрацию в рамках контролируемого экспериментального подхода. Как и другие препринты, размещенные на arXiv, данное предложение отражает методы реализации и тестирования авторов. Перенос этих результатов в производственные системы требует независимого воспроизведения на различных конфигурациях аппаратного обеспечения, архитектурах моделей и шаблонах вывода. Опубликованные эталоны следует рассматривать как результаты исследований, зависящие от конкретных экспериментальных условий, а не как общие гарантии производительности. Операционная компромиссия также отражена в механизме внимания.
Практический вопрос для систем вывода заключается в том, останется ли накладные расходы на поддержание двух хеш-таблиц и вычисление корректировок границ достаточно малыми, чтобы оправдать пользу. Важны аппаратные ограничения. У GPUs и TPUs фиксированная пропускная способность памяти и иерархия кэшей. Перемещение фрагментов кэша изменяет шаблоны доступа к памяти, и влияние на производительность зависит от того, совпадают ли эти шаблоны с сильными сторонами ускорителя. Конфигурация, которая показывает выигрыш по задержке на одном устройстве, может давать уменьшающийся эффект на другом, если логика повторного вычисления выходит из кэша или создаёт конкуренцию за память. Эта изменчивость подчёркивает, почему развертывания машинного обучения требуют тщательного бенчмаркинга на конкретном целевом оборудовании, а не полагаться на общие заявления о производительности. Для более широкого контекста, arXiv описывает соответствующий стандарт или учреждение.
Применения и ограничения
Стратегии повторного использования кэша, как правило, хорошо применимы в сценариях, где подсказки содержат значительное совпадение контента. Системы чат-ботов, где пользователи постепенно уточняют запросы, или пайплайны генерации с расширением за счет извлечения, где несколько запросов используют один и тот же корпус документов, теоретически могут извлечь выгоду. Напротив, нагрузки на вывод с сильно различающимися одноразовыми подсказками предоставляют мало возможностей для повторного использования кэша, независимо от гибкости. Предложение не устраняет фундаментальное ограничение, что фрагменты кэша должны соответствовать допустимым семантическим границам в подсказке, и не решает проблему, что разные модели могут требовать разные структуры кэша. статья по машинному обучению помогает разместить проблему в более широком контексте политики и инженерии.
Вклад в исследование находится в рамках более масштабных инженерных усилий по снижению стоимости вывода больших языковых моделей. Кэширование префиксов, спекулятивное декодирование и квантизация являются дополнительными методами, которые устраняют разные узкие места. KVBoost сосредоточен конкретно на гибкости позиционирования кэша, а не на сжатии модели или скорости генерации. Принятие этого подхода практиками зависит от того, соответствуют ли измеренные задержки и компромиссы по памяти реальным ограничениям развертывания и доказала ли реализация стабильность на различных вариантах моделей. Репродуцируемое исследование стандарты требуют, чтобы утверждения о повышении производительности сопровождались подробным описанием методологии, опубликованным кодом и достаточной документацией для того, чтобы независимые команды могли воспроизвести результаты. Текущий статус KVBoost как препринта указывает на то, что работа является общедоступной, но не прошла рецензирование на крупной платформе. Любому, кто рассматривает возможность интеграции, следует планировать работу по валидации с использованием их конкретного оборудования, модели и нагрузки, вместо того чтобы предполагать, что опубликованные результаты распространяются напрямую.
Темы: инференс LLM, оптимизация KV-кэша, системы машинного обучения, исследования